林小婉
内容创作者
长文选题 / 脚本 / 改稿
“同一个选题我会先让 GPT、Claude、Gemini 各写一版。差异非常明显,有的擅长结构,有的擅长观点,有的能补事实。我通常先看三个方向,再决定哪条线值得继续写。”
官方接入:Anthropic / OpenAI / AWS / Azure / Google

快速了解如何同时与多个模型对话
视频时长:约42秒
顶级模型可以不用,但不能没有!
| 模型 | 亮点 | 能力 |
|---|---|---|
| gpt-5.5 | OpenAI 26年4月下旬旗舰 | 文字、图片 |
| gemini-3.1-pro | 谷歌26年2月份旗舰模型 | 文字、图片 |
| claude-opus-4.7 | Anthropic 26年4月份旗舰模型 | 文字、图片 |
| 模型 | 亮点 | 能力 |
|---|---|---|
| claude-opus-4.6 | Anthropic 26年2月份旗舰模型 | 文字、图片 |
| claude-sonnet-4.6 | Anthropic 26年2月份主力模型 | 文字、图片 |
| gpt-5.4 | OpenAI 26年4月份旗舰模型 | 文字、图片 |
| gemini-3.7-flash | 谷歌26年8月出品的新模型 | 文字、图片、视频 |
| kimi-k2.6 | Kimi 26年4月旗舰 | 文字、图片 |
| deepseek-v4-pro | deepseek 26年4月开源旗舰 | 文字 |
* 单位:美元/百万计费单位
* 可选模型默认并不全部显示,可联系客服开通
* opus 系列只对 Standard / Pro 套餐用户开放
| 输入价格 | 输出价格 | 模型 |
|---|---|---|
| $10.0 | $40.0 | gpt-5.5、claude-opus-4.7 |
| $8.0 | $30.0 | gemini-3.1-pro、claude-opus-4.6 |
| $5.0 | $20.0 | gpt-5.4、claude-sonnet-4.6 |
| $3.0 | $10.0 | gemini-3.7-flash、kimi-k2.6、deepseek-v4-pro |

"这就像获得三个医生的意见一样。我会向多个AI问同样的问题,让它们比较彼此的答案,然后给我所有答案中最好的。"
Jensen Huang
英伟达 CEO
CNN 采访 20256大功能,得心应手

最好的模型,一网打尽,避免视野狭窄

Claude、Gemini、GPT 提供解答

输入斜杠 / 一键调用

快速查看和定位到不同模型的回答
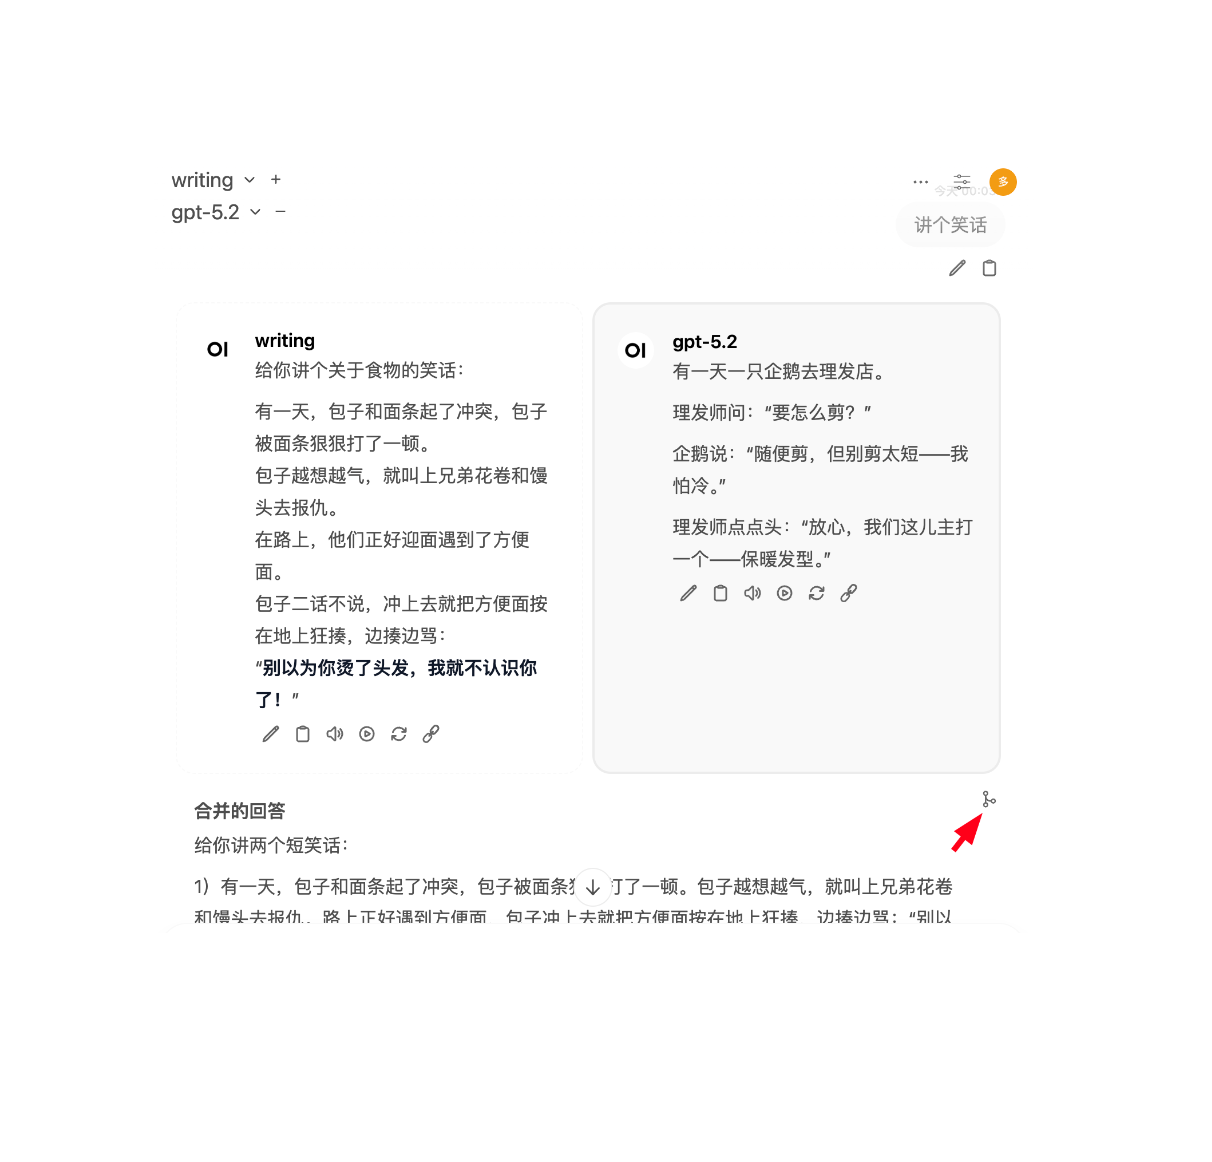
选取多个模型的精华,由指定模型一键生成综合总结

分享对话,与朋友协作

一键安装到手机和电脑,变成桌面软件
同时调用 Claude、Gemini、GPT 三家世界顶尖模型,获得更高质量的答案上限
一次选择多个模型同时提问,在同一界面快速比较不同思路,无需来回切换软件
匿名使用,聊天记录和提示词可随时导出,重要知识沉淀真正属于你
充值的是模型 API 使用额度,不是每月固定会员费;高峰多用,空闲少花,余额长期有效
用户反馈
写作、项目交付、教学备课、法律材料和技术决策都怕漏看角度。多问把同一个任务交给多个模型处理,让你同时看到不同判断、不同风险和不同解法。
林小婉
内容创作者
长文选题 / 脚本 / 改稿
“同一个选题我会先让 GPT、Claude、Gemini 各写一版。差异非常明显,有的擅长结构,有的擅长观点,有的能补事实。我通常先看三个方向,再决定哪条线值得继续写。”
周亦然
项目经理
PDF 审阅 / 风险梳理 / 交付方案
“几十页的 PDF 交给三个模型一起分析,合同条件、验收风险、排期问题基本一个不漏。更有价值的是,不同模型还会给出不同解法,方便我拿去和团队讨论。”
陈妍
教师
备课设计 / 作文反馈 / 课堂讨论
“备课时我会把教材、课堂目标和学生常见问题一起丢进去。几个模型给出的课堂活动和追问角度不一样,最后能拼出一节更完整、更容易落地的课。”
高明
工程技术总监
架构评审 / 技术选型 / 事故复盘
“复杂技术问题多轮问下来,边界条件、性能瓶颈、实现代价基本都清楚了。GPT-5.5 的确强大,尤其适合把混乱的技术讨论收敛成可执行的方案。”
罗诚
律师
合同审阅 / 案情梳理 / 风险清单
“处理长合同和案情材料时,多模型一起列争议点、风险条款和证据缺口,效率很高。果然,文科生离不开满血纯正的 Claude。”
摒弃传统订阅压力,用多少付多少,余额长期有效
没有月租包年压力,余额长期有效
单次充值,随用随扣
无订阅制绑架
你真正拥有你支付的额度,不再为闲置时间买单。
4 组历史记忆上下文
默认携带最近 4 次历史问答作为语境,满足碎片化日常查询。
不含 Claude Opus 系列
Lite 不开放 claude-opus-4.6 和 claude-opus-4.7;需要 Opus 模型可选择 Standard 或 Pro。
预计可用字数
约 20 万汉字对话
以 Gemini 3.1 Pro 为例折算,适合轻量日常工作与临时查询。
模型价格分级
| 输入 | 输出 | 模型 |
|---|---|---|
| $10 | $40 | gpt-5.5、opus-4.7 |
| $8 | $30 | gemini-3.1-pro、opus-4.6 |
| $5 | $20 | gpt-5.4、sonnet-4.6 |
| $3 | $10 | kimi-k2.6、deepseek-v4-pro |
单位:美元 / 百万计费单位
一次充值,解锁3大进阶特权
获取等值 29.9 USD 超大额度
📚 更多组上下文 (4+)
比 Lite 携带更多轮历史,连续对话更连贯。支持扩展至 10 组。
🔍 全球网页搜索
在对话框中开启搜索功能,让 AI 用前沿事实回答复杂问题。
🔓 畅享 Claude Opus
Standard 和 Pro 均可使用 claude-opus-4.6 和 claude-opus-4.7 两个 Anthropic 旗舰模型。
预计可用字数
约 120 万汉字对话
以 Gemini 3.1 Pro 为例折算,满足专业级长文本处理与频繁生成任务。
模型价格分级
| 输入 | 输出 | 模型 |
|---|---|---|
| $10 | $40 | gpt-5.5、opus-4.7 |
| $8 | $30 | gemini-3.1-pro、opus-4.6 |
| $5 | $20 | gpt-5.4、sonnet-4.6 |
| $3 | $10 | kimi-k2.6、deepseek-v4-pro |
单位:美元 / 百万计费单位
适合团队、公司或家庭共用
获取等值 99.9 USD 长期有效额度
最多 3 人共享额度
总额度可在 3 个账号之间自由分配,适合团队协作、家庭共用和公司集中采购。
定制专属系统提示词
基于 GPT-5.5 等最强模型,AI 咨询师进一步帮你打磨可复用、结构化的系统提示词,形成专属模型,获得稳定输出。
全部问答历史可进入上下文
不设固定轮数限制,更适合长期项目、深度研究和连续创作。
预计可用字数
约 400 万汉字对话
以 Gemini 3.1 Pro 为例折算,适合长期项目、深度研究和连续创作。
模型价格分级
| 输入 | 输出 | 模型 |
|---|---|---|
| $10 | $40 | gpt-5.5、opus-4.7 |
| $8 | $30 | gemini-3.1-pro、opus-4.6 |
| $5 | $20 | gpt-5.4、sonnet-4.6 |
| $3 | $10 | kimi-k2.6、deepseek-v4-pro |
单位:美元 / 百万计费单位
* 取消传统月付季付绑定模式;所有充值额度按量计算扣减,系统无过期清零时间套路
* 以 Gemini 3.1 Pro 为例核算:$8/百万token输入,$30/百万token输出(基于多问平台整合加持后的定价计算)
* 汉字量为按「一半输入 / 一半输出」平均成本粗略估算得出,实际消耗随场景变动
Lite 4 组上下文:日常够用
Standard / Pro 更多上下文:深度连贯
Standard / Pro 专属扩展权:Lite 固定携带 4 组历史上下文;Standard 默认携带更多组,Pro 可让全部问答历史进入上下文,更适合长期项目和硬核学术需求。
Standard / Pro 用户专属功能 — 让 AI 不再凭空回答,用全球最新事实为你的问题提供支撑
实时搜索全球中英文网页
AI 会在回答前先搜索最新资料,确保引用的信息是准确和前沿的。
一键开启,无缝集成
在对话框底部点击「扩展功能」图标后选择「开启搜索」,即可开启搜索能力。无需离开对话界面。
适用场景
最新新闻事件、学术论文速查、竞品分析、技术文档检索等一切需要事实支撑的场景。
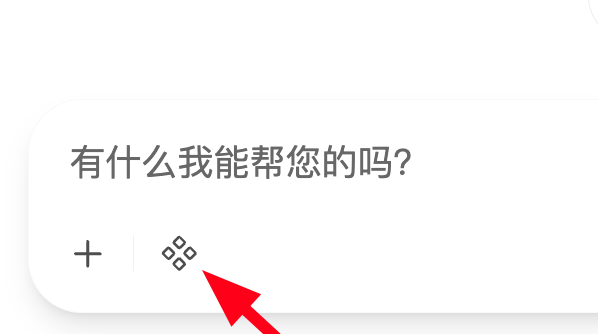
💡 搜索功能使用 Tavily 引擎,专为 AI 深度理解而优化。在对话框底部点击「扩展功能」图标即可开启。
选择最好的回答后,继续追问
技术债、监控缺口、回滚预案最清楚。
补用户路径、数据口径、发布节奏。
列出文档假设、责任边界和沟通缺口。
执行清单很强,但偏工程视角。
补充体验验证和数据指标。
责任边界、验收标准、沟通风险更完整。
保留技术方案和优先级。
把多轮结论变成行动表。
保留风险表述和沟通话术。
追问会继承你选中的那条回答,避免三个模型的内容混在一起。
第一轮选 GPT,第二轮改选 Claude,第三轮再让 Gemini 整理输出。
多模型分歧留在页面上,最终可以沉淀成清单、表格和可执行方案。
以 29.9 USD 的 Standard 额度为例测算;Pro 为 99.9 USD,约为 Standard 的 3 倍用量
图表依 Standard 额度测算;Pro 约为 3 倍 | 1 个汉字 ≈ 4 个计费单位 (Token)
覆盖 gpt-5.5、claude-opus-4.7、gemini-3.1-pro、claude-opus-4.6
覆盖 gpt-5.4、claude-sonnet-4.6、kimi-k2.6、deepseek-v4-pro
我们很乐意听到您的声音。无论是商务合作、批量折扣、获取支持还是提供反馈,选择最适合的联系方式。
在线回复,快速解决问题
适合技术支持与产品咨询
邮箱地址:wenwen[at]duowen.app